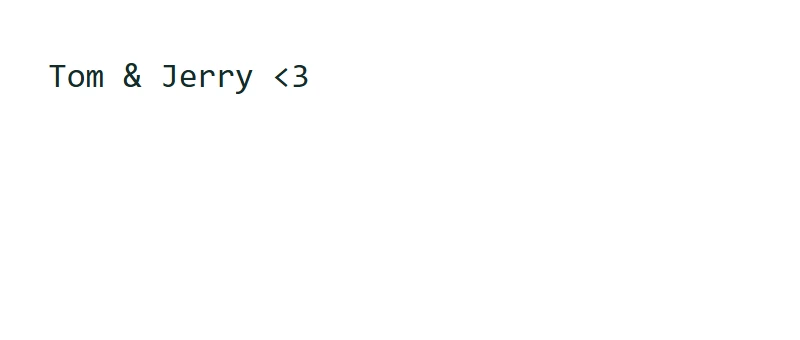

Преобразуйте распознанные HTML сущности обратно в их символы, сохраняя результат доступным для редактирования в виде простого текста. Следуйте приведенным ниже входным данным и настройкам, чтобы воспроизвести этот пример. Открыть Декодирование HTML.
Подготовьте исходный текст
Откройте декодирование HTML и выберите «Написать» или «Вставить текст», либо загрузите поддерживаемый текстовый файл UTF-8. Загрузка открывает редактор; она не запускает инструмент. В этом примере используются точные исходные данные, показанные в сравнении.
Максимальный объем ввода и результата: 1 МБ UTF-8 текста с ограничением в 1,048,576 символов для ввода. Расширяющие преобразования также должны укладываться в лимит результата.
Использовать точный пример ввода
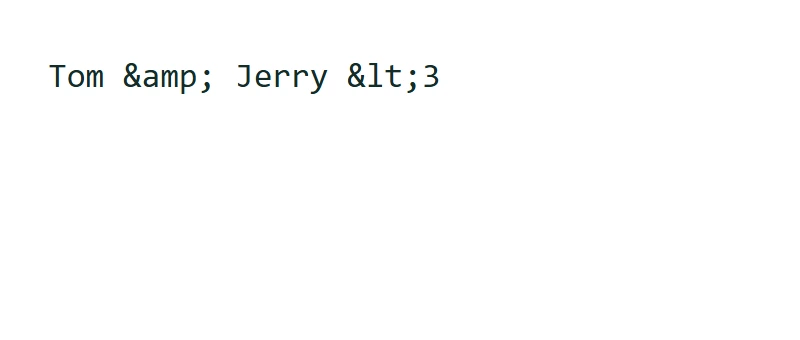
Tom & Jerry <3
Эта операция выполняется в вашем браузере; исходные данные и результат не отправляются на сервер для конвертации. Черновик может сохраняться во вкладке браузера, если доступно хранилище сеанса. Кнопка «Очистить» удаляет текущий черновик; сохраняйте важную работу перед закрытием вкладки.
Проверьте, как работает инструмент
У этого инструмента нет дополнительных параметров преобразования для настройки. Оставьте исходный код точно таким, как показано, чтобы сравнить результат.
Ссылки, такие как & и <, превращаются в амперсанды и угловые скобки. Результат помещается в редактируемое текстовое поле, а не выполняется как веб-страница. Декодирование происходит для введенных вами данных; многократно закодированный контент может потребовать повторной обработки.
Пример из этого руководства
Проверено в рабочем процессе браузера i2TEXT в ноябре 11, 2026.
- Входные данные
- example.txt
- Результат
- html-decode.txt
- Сохраненный результат
- 14 байт
Примените и проверьте результат
Выберите декодирование HTML, когда входные данные и настройки будут готовы. В сохраненном примере результат начинается с: "Tom & Jerry <3".
Декодирование сущностей не удаляет теги HTML. Используйте HTML в текст, если вам нужно текстовое содержимое документа с разметкой.
Проверьте декодированные ссылки в моноширинном результате и сравните размер в байтах UTF-8 входных и выходных данных в «Обзоре результата». Угловые скобки остаются редактируемым текстом; отчёт не отображает декодированное содержимое как веб-страницу.
Обзор результата позволяет различать изменённые, неизменённые и пустые результаты. Неизменённый результат означает, что выбранная операция не изменила текст; пустой результат может быть ожидаемым итогом удаления или извлечения. Откройте «Показать пробелы и табуляцию», чтобы увидеть пробелы как ·, табуляцию как ⇥, а окончания строк как ↵. Эти отметки — лишь предпросмотр; скопированный и скачанный текст сохраняет свои фактические пробельные символы. Предпросмотр пробельных символов показывает не более 12,000 кодовых точек Unicode. Это ограничение предпросмотра не сокращает редактируемый результат или его скачивание в формате TXT.
Сохраните версию, которую вы проверили
Проверьте текущий результат, затем используйте значок загрузки, чтобы сохранить файл TXT. Фактическая загрузка в этом примере называется html-decode.txt. Копирование и скачивание используют текущий результат, поэтому внесите все окончательные правки в текст перед сохранением. «Перейти к» позволяет передать результат в совместимый следующий инструмент, где вы сможете проверить его перед выполнением другой операции.
Редактирование результата скрывает вычисленные детали до тех пор, пока вы снова не запустите инструмент. Копирование и скачивание TXT используют отредактированный текст; вернитесь к источнику и примените инструмент повторно, чтобы обновить отчёт.
example.txthtml-decode.txt
Часто задаваемые вопросы
Какие настройки привели к этому результату?
Дополнительные настройки преобразования не потребовались. Исходный код и фактический вывод показаны в сравнении.
Что нужно проверить перед использованием результата?
Декодирование сущностей не удаляет теги HTML. Используйте HTML в текст, если вам нужно текстовое содержимое документа с разметкой.
Где обрабатывается этот текст?
Эта операция выполняется в вашем браузере; исходные данные и результат не отправляются на сервер для конвертации. Черновик может сохраняться во вкладке браузера, если доступно хранилище сеанса. Кнопка «Очистить» удаляет текущий черновик; сохраняйте важную работу перед закрытием вкладки.
Попробуйте декодирование HTML с собственным текстом.
Используйте свой собственный источник и проверьте результат перед публикацией.