
Превърнете разпознатите HTML обекти обратно в техните символи, като същевременно запазите резултата редактируем като обикновен текст. Следвайте точните входни данни и настройки по-долу, за да възпроизведете този пример. Отворете HTML Декодиране.
Подгответе изходния текст
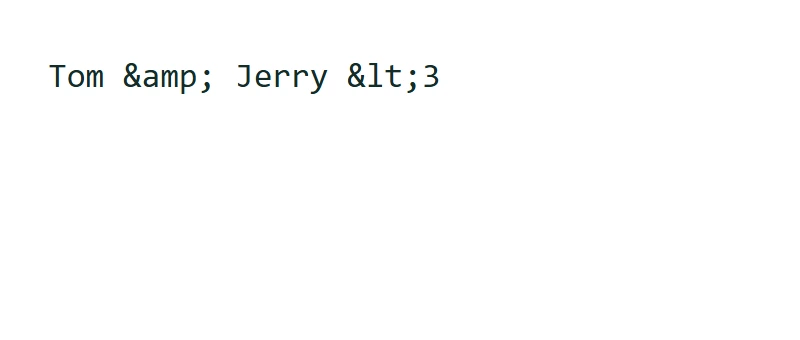
Отворете HTML декодиране и изберете „Писане“ или „Поставяне на текст“, или качете поддържан UTF-8 текстов файл. Качването отваря редактора; то не стартира инструмента. Този пример използва точния източник, показан в сравнението.
Максимален вход и резултат: 1 MB UTF-8 текст, с ограничение от 1,048,576 знака за вход. Разширяващите трансформации също трябва да се вписват в ограничението за резултата.
Използвайте точния примерен вход
Tom & Jerry <3
Тази текстова операция се изпълнява във вашия браузър; нейният източник и резултат не се изпращат за преобразуване. Чернова може да бъде запазена в този раздел на браузъра, когато е налична сесийна памет. Изчистването премахва текущата чернова; изтеглете важната работа, преди да затворите раздела.
Проверете как работи инструментът
Този инструмент няма допълнителни опции за трансформиране. Запазете източника точно както е показано, за да сравните резултата.
Препратки като & и < стават амперсанди и ъглови скоби. Резултатът се поставя в редактируемо текстово поле, вместо да се изпълнява като уеб страница. Декодирането се извършва за предоставения от вас вход; многократно кодираното съдържание може да се нуждае от още един целенасочен проход.
Примерът в това ръководство
Проверено в работния процес на браузъра i2TEXT на 11 ноември 2026.
- Вход
- example.txt
- Изход
- html-decode.txt
- Запазен резултат
- 14 байта
Приложете и проверете резултата
Изберете HTML декодиране, когато входните данни и настройките са готови. В запазения пример резултатът започва с: "Tom & Jerry <3".
Декодирането на обекти не премахва HTML тагове. Използвайте HTML към текст, когато имате нужда от текстовото съдържание на документ с маркировка.
Проверете декодираните препратки в моноширинния резултат и сравнете байтовите размери на входа и резултата UTF-8 в „Преглед на резултата“. Ъгловите скоби остават редактируем текст; отчетът не изобразява декодираното съдържание като уеб страница.
Преглед на резултата разграничава променени, непроменени и празни резултати. Непромененият резултат означава, че избраната операция не е променила текста; празният резултат може да бъде очакваният изход от премахване или извличане. Отворете Показване на интервали и табулации, за да разкриете интервалите като ·, табулациите като ⇥ и крайните знаци на реда като ↵. Тези знаци са само за преглед; копираният и изтегленият текст запазват действителните си празни пространства. Прегледът на празните пространства показва най-много 12,000 Unicode кодови точки. Този лимит на прегледа не съкращава редактируемия резултат или неговото TXT изтегляне.
Запазете версията, която прегледахте
Прегледайте текущия резултат, след което използвайте иконата за изтегляне, за да запишете TXT файл. Действителното изтегляне в този пример е с име html-decode.txt. Копирането и изтеглянето използват текущия резултат, така че направете всички финални промени по текста, преди да запишете. „Продължи към“ може да пренесе резултата в съвместим следващ инструмент, където да го прегледате, преди да стартирате друга операция.
Редактирането на резултата скрива изчислените подробности, докато не пуснете инструмента отново. Копирането и TXT изтеглянето използват редактирания текст; върнете се към източника и приложете инструмента отново, за да обновите отчета.
example.txthtml-decode.txt
Често задавани въпроси
Кои настройки доведоха до този пример?
Не бяха необходими допълнителни настройки за трансформиране. Изходният текст и действителният резултат са показани в сравнението.
Какво трябва да проверя, преди да използвам резултата?
Декодирането на обекти не премахва HTML тагове. Използвайте HTML към текст, когато имате нужда от текстовото съдържание на документ с маркировка.
Къде се обработва този текст?
Тази текстова операция се изпълнява във вашия браузър; нейният източник и резултат не се изпращат за преобразуване. Чернова може да бъде запазена в този раздел на браузъра, когато е налична сесийна памет. Изчистването премахва текущата чернова; изтеглете важната работа, преди да затворите раздела.
Опитайте HTML декодиране с ваш собствен текст.
Използвайте собствен източник и прегледайте резултата, преди да го споделите.