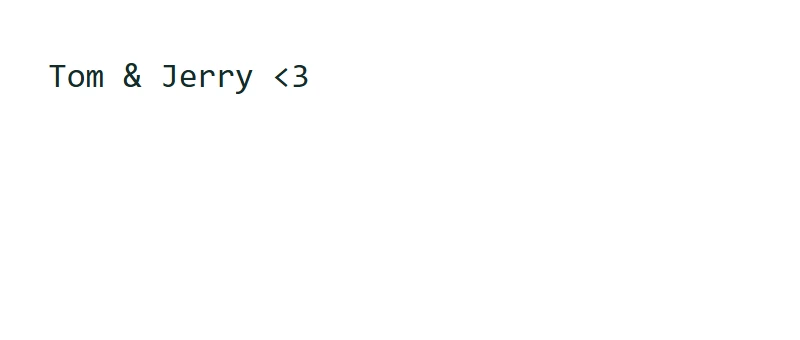

Převeďte rozpoznané entity HTML zpět na jejich znaky a ponechte výsledek upravitelný jako prostý text. Pro reprodukci tohoto příkladu postupujte podle přesného vstupu a nastavení níže. Otevřít Dekódování HTML.
Připravte zdrojový text
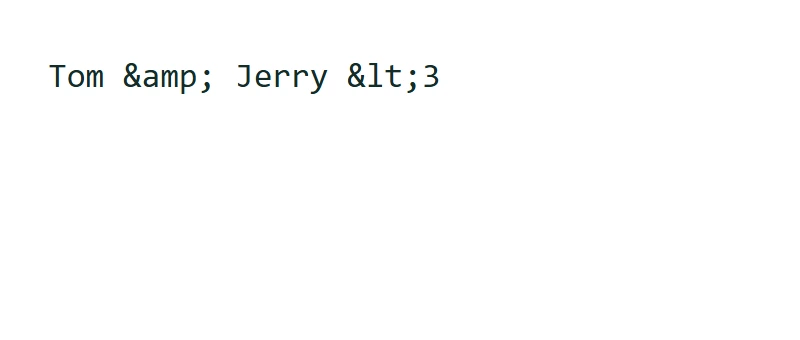
Otevřete dekódování HTML a zvolte Napsat nebo vložit text, případně nahrajte podporovaný textový soubor UTF-8. Nahrání otevře editor; nespustí nástroj. Tento příklad používá přesný zdroj zobrazený v porovnání.
Maximální vstup a výsledek: 1 MB UTF-8 textu, s limitem 1,048,576 znaků na vstupu. Rozšiřující transformace se také musí vejít do limitu výsledku.
Použijte přesný příklad vstupu
Tom & Jerry <3
Tato textová operace probíhá ve vašem prohlížeči; zdroj ani výsledek nejsou odesílány ke konverzi. Pokud je k dispozici úložiště relace, může být koncept uložen na této kartě prohlížeče. Vymazat odstraní aktuální koncept; před zavřením karty si důležitou práci stáhněte.
Podívejte se, jak nástroj funguje
Tento nástroj nemá žádné další možnosti transformace k nastavení. Ponechte zdroj přesně tak, jak je zobrazen, pro porovnání výsledku.
Reference jako & a < se změní na ampersandy a lomené závorky. Výsledek je umístěn do upravitelného textového pole, nikoliv spuštěn jako webová stránka. Dekódování probíhá pro vámi dodaný vstup; opakovaně kódovaný obsah může vyžadovat další cílený průchod.
Příklad v tomto průvodci
Ověřeno v pracovním postupu prohlížeče i2TEXT dne 11. listopadu 2026.
- Vstup
- example.txt
- Výstup
- html-decode.txt
- Uložený výsledek
- 14 bajtů
Aplikujte a zkontrolujte výsledek
Jakmile jsou vstup a nastavení připraveny, vyberte dekódování HTML. V uloženém příkladu výsledek začíná: "Tom & Jerry <3".
Dekódování entit neodstraňuje značky HTML. Použijte HTML to Text, pokud potřebujete textový obsah dokumentu se značkami.
Zkontrolujte dekódované odkazy v neproporcionálním výsledku a porovnejte velikosti bajtů vstupu a výsledku UTF-8 v Přehledu výsledku. Úhlové závorky zůstávají upravitelným textem; přehled nevykresluje dekódovaný obsah jako webovou stránku.
Přehled výsledku rozlišuje změněné, nezměněné a prázdné výsledky. Nezměněný výsledek znamená, že vybraná operace text neupravila; prázdný výsledek může být očekávaným výsledkem odstranění nebo extrakce. Otevřete Zobrazit mezery a tabulátory pro odhalení mezer jako ·, tabulátorů jako ⇥ a konců řádků jako ↵. Tyto značky jsou pouze náhledem; zkopírovaný a stažený text si zachovává své skutečné bílé znaky. Náhled bílých znaků zobrazuje maximálně 12,000 kódových bodů Unicode. Tento limit náhledu nezkracuje upravitelný výsledek ani jeho stažení TXT.
Uložte verzi, kterou jste zkontrolovali
Zkontrolujte aktuální výsledek a poté použijte ikonu stahování pro uložení souboru TXT. Skutečný soubor ke stažení v tomto příkladu je pojmenován html-decode.txt. Kopírování a stahování používají aktuální výsledek, proto před uložením proveďte veškeré konečné úpravy textu. Pokračovat na může přenést výsledek do kompatibilního dalšího nástroje, kde jej před spuštěním další operace zrevidujete.
Úprava výsledku skryje vypočítané podrobnosti, dokud nástroj znovu nespustíte. Kopírování a stahování TXT používají upravený text; vraťte se ke zdroji a znovu aplikujte nástroj pro aktualizaci přehledu.
example.txthtml-decode.txt
Časté dotazy
Která nastavení vytvořila tento příklad?
Nebyla vyžadována žádná další nastavení transformace. Zdroj a skutečný výstup jsou zobrazeny v porovnání.
Co bych měl zkontrolovat před použitím výsledku?
Dekódování entit neodstraňuje značky HTML. Použijte HTML to Text, pokud potřebujete textový obsah dokumentu se značkami.
Kde je tento text zpracován?
Tato textová operace probíhá ve vašem prohlížeči; zdroj ani výsledek nejsou odesílány ke konverzi. Pokud je k dispozici úložiště relace, může být koncept uložen na této kartě prohlížeče. Vymazat odstraní aktuální koncept; před zavřením karty si důležitou práci stáhněte.
Vyzkoušejte dekódování HTML s vlastním textem.
Použijte svůj vlastní zdroj a před sdílením zkontrolujte výsledek.