

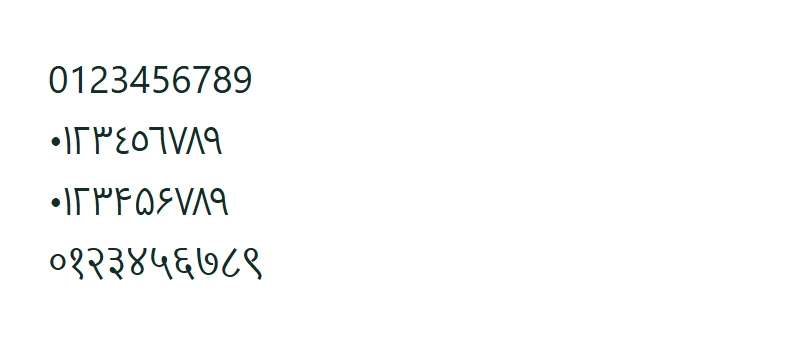

周囲のテキストを保持しながら、サポートされている数字文字を選択した1つの数字セットに変換します。以下の入力と設定に従ってワークフローを進めてください。 数字の正規化を開く.
ソーステキストを準備する
「数字の正規化」を開き、テキストを入力または貼り付けるか、サポートされている UTF-8 テキストファイルをアップロードします。アップロードするとエディターが開きますが、ツールは実行されません。この例では、比較に示されている正確なソースを使用しています。
最大 1 MB の UTF-8 入力および結果、1,048,576 文字の上限があります。
正確な入力例を使用する
0123456789
٠١٢٣٤٥٦٧٨٩
۰۱۲۳۴۵۶۷۸۹
०१२३४५६७८९
正規化は、送信時に決定論的なサーバー操作として実行されます。生成AIリクエストは使用しません。一時的なテキスト処理ファイルは、リクエスト終了時に削除されます。
設定を選択する
記録された例では、次の設定を使用します:数字形式:ラテン数字:0123456789。
ラテン、アラビア、ペルシャ、ヒンディー数字から選択します。コンバーターは、認識された数字を対応するセットから選択したセットの数値にマッピングします。単語、空白、その他の文字はそのまま残ります。
このガイドの例
i2TEXTブラウザワークフローにて、11年2026月確認済み。
- 入力
- example.txt
- 出力
- normalize-numbers.txt
- 保存された結果
- 43 バイト
適用して結果を確認する
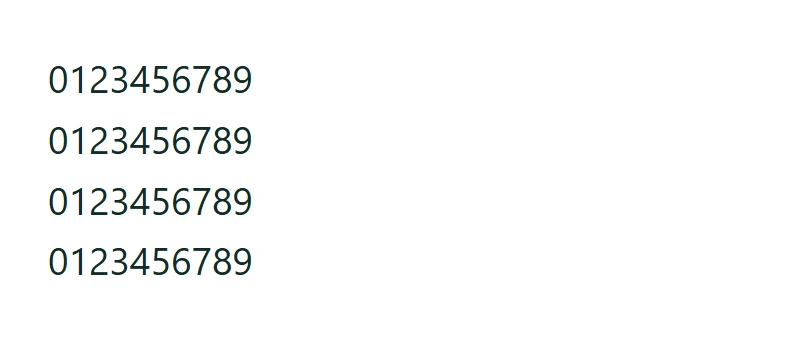
入力と設定の準備ができたら「数字の正規化」を選択します。これにより処理リクエストが送信されます。サンプルを読み込んだり、オプションを変更したりするだけでは送信されません。保存された例では、結果は "0123456789" で始まります。
数字の正規化はロケールフォーマットではありません。区切り記号、数字の言葉、サポートされていない数字システムは変換されません。
確認したバージョンを保存する
現在の結果を確認し、「テキストをダウンロード」を使用して TXT ファイルを保存します。この例での実際のダウンロードファイル名は normalize-numbers.txt です。「コピー」と「ダウンロード」は現在の結果を使用するため、保存前に最終的な文言の変更を行ってください。「継続」を使用すると、結果を互換性のある次のツールに引き継ぐことができ、別の操作を実行する前に確認できます。
example.txtnormalize-numbers.txt
よくある質問
この例を作成した設定は何ですか?
数字形式:ラテン数字:0123456789。
結果を使用する前に何を確認すべきですか?
数字の正規化はロケールフォーマットではありません。区切り記号、数字の言葉、サポートされていない数字システムは変換されません。
このテキストはどこで処理されますか?
正規化は、送信時に決定論的なサーバー操作として実行されます。生成AIリクエストは使用しません。一時的なテキスト処理ファイルは、リクエスト終了時に削除されます。
独自のテキストで「数字の正規化」を試してみましょう。
独自のソースを使用し、共有する前に結果を確認してください。


